how to keep same character across AI images:AI 漫画与分镜里让同一个角色每一格都长一样
how to keep same character across AI images:AI 漫画与分镜里让同一个角色每一格都长一样
长尾词:how to keep same character across AI images · AI comic consistent characters multiple panels · AI storyboard same person every frame
搜 "how to keep same character across AI images" 的人,通常已经卡在第三格;搜 "AI comic consistent characters multiple panels" 的是在做连载的漫画作者;搜 "AI storyboard same person every frame" 的是分镜师——镜头表上写着同一个名字,每一格出来的却是不同的人。
这篇分三段:痛点、通用解法(参考图 / LoRA / 固定种子怎么选)、PolyCreator 的实际做法,最后是流程、问答与延伸阅读。
一、痛点:六格漫画画出了六个人
失败从来不是"完全不像",而是每一处都差一点:
- 五官比例在漂。 第一格定稿是圆下巴,第三格变方下巴;发际线的高度、眼睛间距、瞳色深浅都在变。正面特写没问题,一转成四分之三侧脸,鼻子和下颌的比例立刻对不上。
- 服装跟着漂。 外套变成开衫,第一格那件红夹克在第四格是灰色的。
- 头身比被镜头改了。 换成广角之后角色显得更圆更小,和前几格并排放就不是同一个人。
- 描述写得再细也救不回来。 提示词里写"黑发、琥珀色眼睛、下巴一颗痣",模型确实会照做,但它是在每一格重新画一个人,不是照着上一格继续画。
- 问题总是最后一格才暴露。 第五格才发现不是同一个人,返工成本是整条链重跑:再等一遍,再付一次服务商的钱。
根子在这里:文生图的输入里只有文字,没有"这个人"。 文字描述能锁住"这一类人"——黑发、琥珀眼、圆脸——锁不住"这一个人"。原因不是描述不够,而是模型侧没有可绑定的角色对象。
二、通用解法:三条路
- 参考图路线。 把一张定稿的脸当作参考图喂给模型,也就是 img2img、IP-Adapter、角色参考(character reference)这一类做法。模型生成新画面时把参考图当条件,把"参考图里的人"和"我要画的人"拉到一起。
- LoRA / DreamBooth 训练路线。 拿十几到几十张同一个角色的照片训练一个专属小模型,之后每次出图都挂上它。r/StableDiffusion 上那个问"有没有靠谱教程"的帖子底下,回复说得很直接:"IP-Adapter is what usually being used for it, but LoRA is the most effective and accurate way." 同一帖还给了素材量经验值:SDXL 大概要 15 到 30 张图,Flux 十张左右就够(原帖)。
- 固定种子 + 固定提示词路线。 同一个 seed、同一个模型、同一段描述词,靠采样可复现性拿回相似的结果。
| 参考图(IP-Adapter / 角色参考) | LoRA / DreamBooth 训练 | 固定种子 + 固定提示词 | |
|---|---|---|---|
| 一致性强度 | 中高。脸型、发色、瞳色稳定,换大幅度机位或光线时仍会滑 | 高。角色被"写进"权重,正侧背、远近景都认得出来 | 低到中。多数场景只是"像",不是"同一个人" |
| 上手成本 | 低。一张图 + 一个支持参考图的模型 | 高。备素材、标数据、调参数,训完还要验 | 低。填个数字就行 |
| 显存或算力要求 | 无额外要求,跟普通出图一样,按服务商计费 | 重。要显卡和数小时到数十小时,推理时模型体积也变大 | 无额外要求 |
| 适合场景 | 漫画分格、短视频分镜、一组固定角色的系列图 | 长期连载的角色、IP 运营、反复出现的主角 | 单张图的复现和微调 |
| 局限 | 强度取决于模型;参考图有数量上限;参考图里的背景、光线容易带进结果 | 素材不足会过拟合;训练门槛高;不同基座不通用 | 后端不一定认 seed;换模型即失效 |
三条路不是互斥的,但起作用的顺序很清楚:参考图解决"是不是同一个人",LoRA 解决"是不是任何角度都像同一个人",种子只解决"这张图能不能重出一遍"。
只做一组漫画或一条分镜,参考图这条路的性价比最高:一张定稿照、零训练成本、一条连线就能复用。准备做几十话的长篇主角、让同一个 IP 形象在几十个场景里反复出现,LoRA 才值得投入。种子单独用撑不住角色一致性,把它当成"同一格重跑时省一次钱"的工具更合适。
三、PolyCreator 怎么做
先说清楚这个应用不做什么:
- 应用里没有 LoRA 训练。 没有训练界面、没有数据集管理、没有采样器参数。服务商模型列表里带 flux-lora 字样的端点属于服务商侧,用你自己的 key 调用,不是应用内训好的模型。要训角色模型,路线仍然是 ComfyUI 那套本地流程。
- 应用里没有角色锁。 没有"这个角色叫张三,以后所有图里的张三都长这样"的注册表。一致性来自你每次手动喂同一张参考图这件事本身。
PolyCreator 是画布和路由层:它把"参考图 → 提示词 → 模型"摆成一条可重复的链路,并保证同一条链跑十次时,参考图是同一张、顺序也是同一张。
1. 参考图节点:一次定稿,处处复用
画布上的节点就是流程,连线就是数据流。
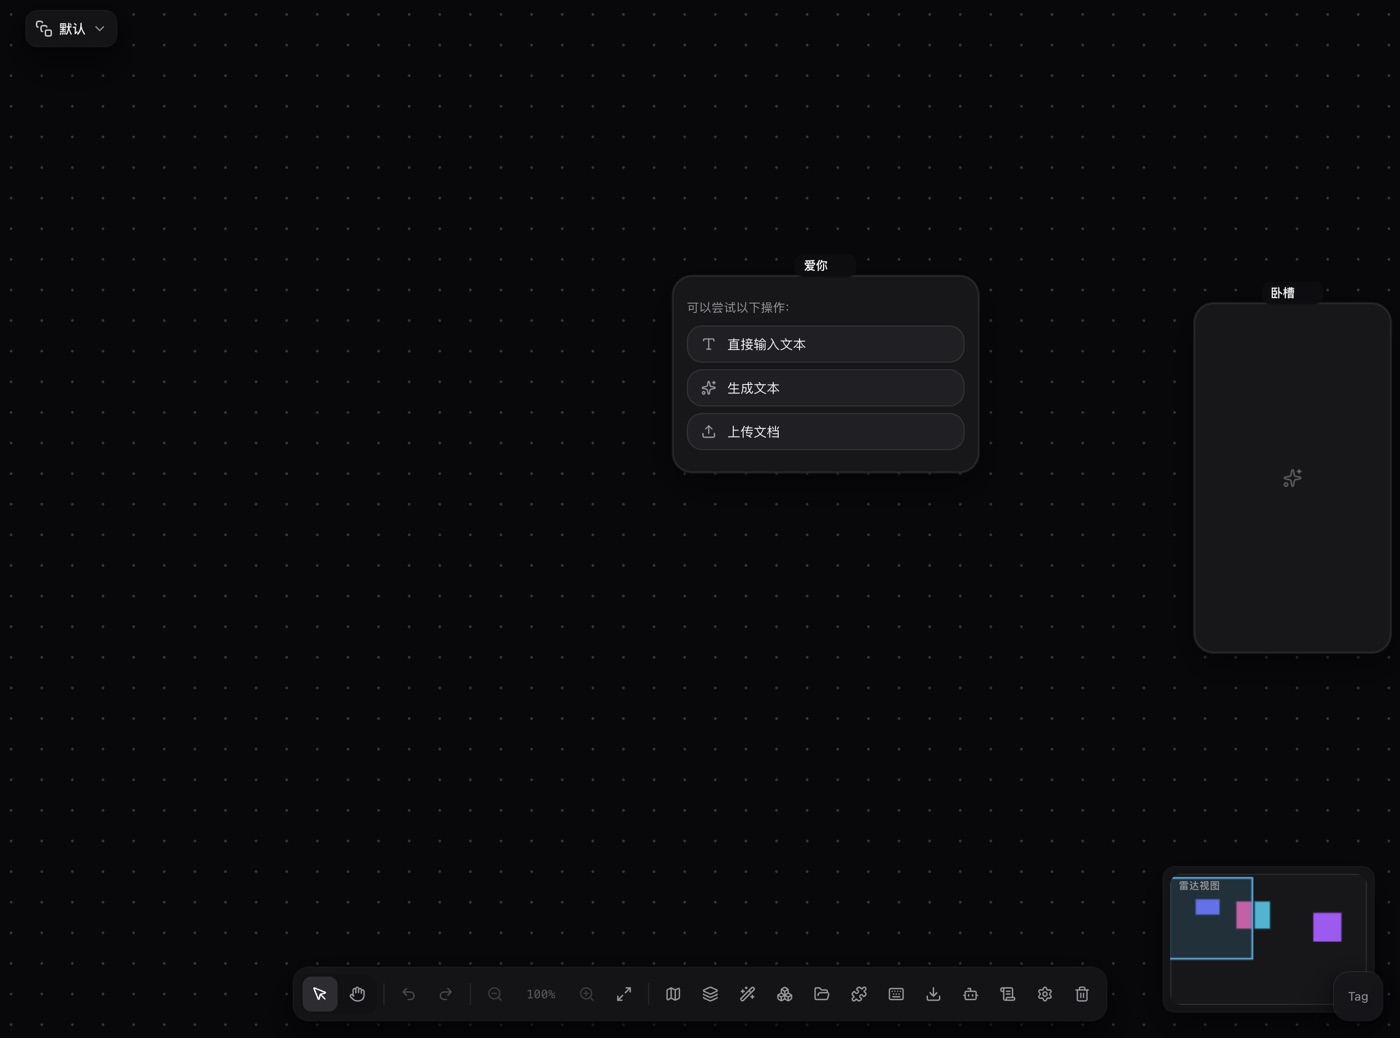
- 新建一个「上传资产」节点,把定妆照传进去。这个节点收到图片后会自己变成图片节点,图片留在原地,不会被后面任何一次生成覆盖。
- 从这个图片节点拉一条线,连到新建的图片生成节点。上游图片自动成为参考图,请求从文生图变成图生图。
- 要六格,就从同一个参考节点拉六条分支。 每个分支一个图片生成节点,六格并排在画布上。原图节点是只读起点,任何一次生成都动不到它。
- 参考图在提示框上方按发送顺序编号(Image1、Image2),点缩略图把
@Image1插进光标处。提示词点名"保持 @Image1 中这张脸"比泛泛写"保持同一个人"有效得多。
这是整篇里唯一被真正锁死的东西:六次请求里发送的第一张参考图完全相同。
2. 模型路由:参考图走哪条路由决定
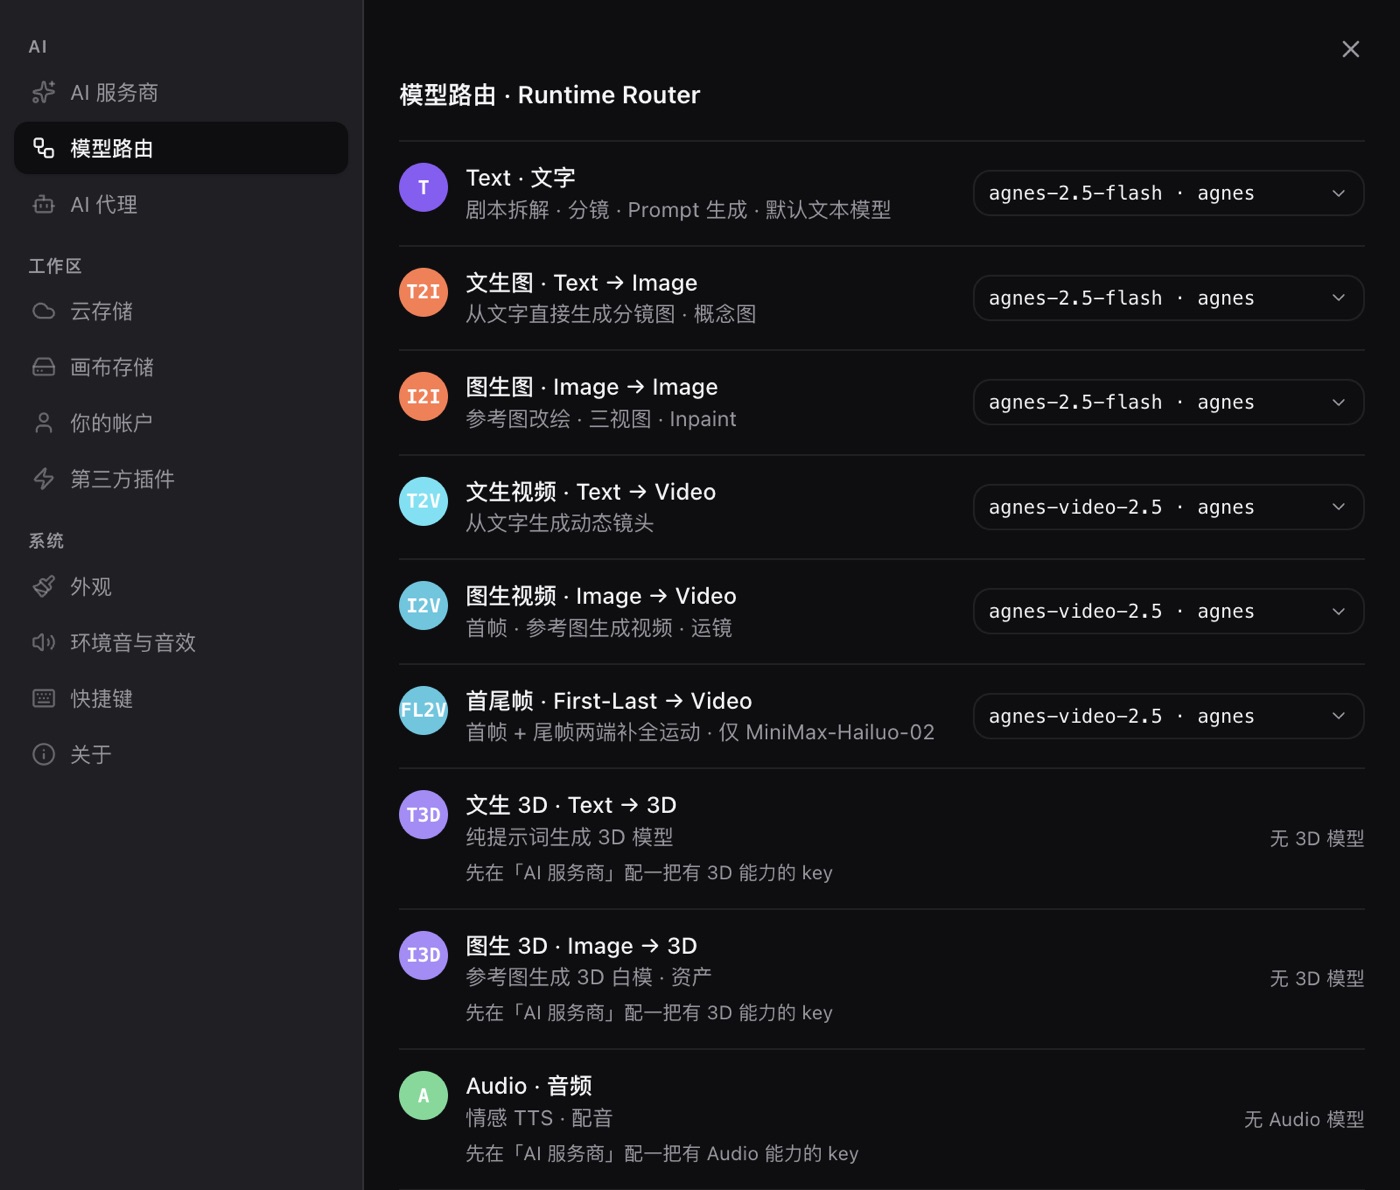
「设置 → 模型路由」按任务分配服务商和模型,图生图那一行就是参考图搭车的地方。节点上的模型胶囊可以单独指定模型,优先于路由。
有个硬约束:部分模型只支持文生图,接参考图会直接报错(MiniMax image-01 明确拒绝参考图)。先把「图生图」这行指向一个支持参考图的模型。同一角色的六格必须走同一个模型,混着来等于换人。
3. 种子:别把希望押在上面
节点的数据结构里有一个 seed 字段,但出图请求并不把它传给服务商;即使传了,多数后端也不保证同种子同图,有的每次调用都换新的随机种子。种子是复现工具,不是一致性来源。 同一格重跑时它能省一次钱,换不了发际线。
4. 角色描述逐字复用,画风交给风格节点
同一套角色描述("二十来岁男性,黑色短发,琥珀色眼睛,下巴一颗痣,深灰工装外套")在六格里逐字复用,一个字都不改,要改的只有场景、动作和机位段。
画风那半截用「存为风格」固定:图片节点上点「存为风格」,把提示词预填进来,删掉主体那半截、只留画风,它就进了资产库的「我的风格」。之后用风格节点连进生成节点,风格描述会在发送前折进提示词正文。
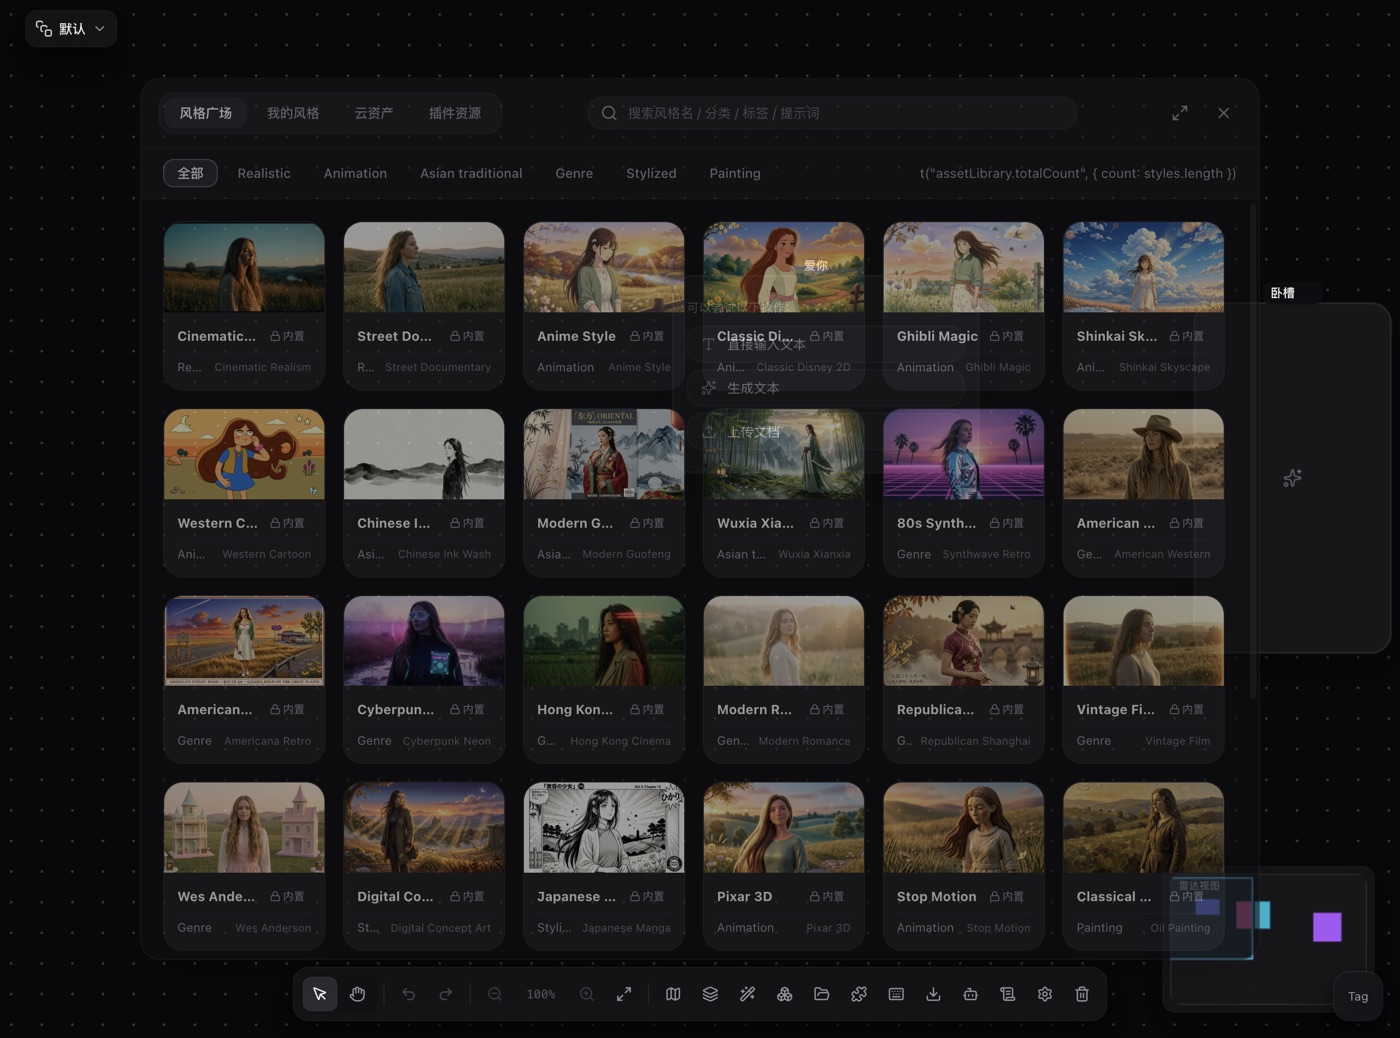
参考图本身也值得放进资产库:云资产里存一份,换项目时直接拖回画布。
5. 群组、图层与命名
六格用群组打包成一个"第 1 话"或"场景 3",整体拖动、整体存成宏模版;图层用来纵向区分"定妆照 / 分格 / 成品"。给参考图节点起名"主角 · 定妆照",六条分支一眼就知道喂的是谁。
四、实操流程
做定妆照。 用文生图生成角色正面半身像,1:1 或 3:4,光线中性、背景干净。这一张的质量决定后面所有格的上限。
定稿并存档。 满意的那张留在画布的「上传资产」节点上,它从此只读。
建参考节点。 上传定妆照,「上传资产」节点自动变成图片节点。
每格一个分支。 从参考节点拉出 N 个图片生成节点,用群组打包,比例统一(漫画格常用 4:3 或 3:4)。
写可复用的提示词模板。 角色描述段逐字复用,只替换场景/动作/机位段:
保持 @Image1 中人物的脸型、发型、瞳色与服装完全一致。
场景:<这一格发生的地方>。动作:<这一格的动作>。机位:<中景 / 近景 / 过肩>,<镜头高度>。
画风:<统一的画风词>。
确认模型。 节点上的模型胶囊选一个支持参考图的模型,整组格子用同一个。中途换模型等于换演员。
出图并自检。 六格并排看缩略图,逐项核对:发际线、下颌线、眼睛间距与瞳色、衣服款式、头身比。不合格的那一格删掉节点重跑,不要动参考图节点——参考图一改,六格全部要重来。
收尾。 满意的画风存成风格,整组格子存成宏模版,下一话直接复用;成图接发布节点发出去。
常见问题
Q:应用里能训练自己的角色 LoRA 吗?
不能。应用里没有 LoRA 训练界面,也没有采样器参数。服务商模型列表里带 flux-lora 字样的端点属于服务商侧,用你自己的 key 调用,不是应用内训好的模型。要训模型请走 ComfyUI 那条本地路线。
Q:固定 seed 能保证同一张脸吗?
不能。节点上有 seed 字段,但出图请求不把它传给服务商;即使传了,多数后端也不保证同种子同图。种子只能省掉"同一格重跑"的成本。
Q:同一段提示词复制到六个节点,不就应该是同一个人了吗?
提示词是必要条件,不是充分条件。同一段描述词得到的是"同一类人",不是"这一个人"。要锁到同一个人,得给模型一张参考图。
Q:接了参考图却报错说只支持文生图?
那个模型不支持图生图(MiniMax image-01 会明确拒绝)。换一个支持参考图的模型,并检查「模型路由」里的图生图行。
Q:一格里放两个人,或者格子内部画两小格,还能保住脸吗?
难。两张参考图的混合容易产出两张"介于两者之间"的脸;参考图数量本身也有模型上限。一次生成里没有"角色 ID",模型分不清哪个是主角。一个格子放一个人更稳,群像用中景处理。
Q:这套做法在连续剧集上够用吗?费用怎么算?
够用,但有边界。参考图路线在十几格、一组固定角色的范围内稳定;主角要在几十个场景、几十种光线里反复出现,就该考虑训 LoRA 了。费用按服务商的单价、用你自己的 key 计费,应用不另外收推理费;参考图路线不增加调用次数。
相关阅读
- 新手入门:十分钟装好桌面端,认识画布上的节点
- 模型与服务商配置:BYOK、模型路由、参考图容量与计费
- 安装与管理插件:给画布加新节点类型与新能力
- ComfyUI 太难?零门槛节点式生图指南:想训自己模型时的另一条路线