AI talking avatar lip sync bad fix:口型对不上怎么修,多段课程视频怎么保住同一张脸
AI talking avatar lip sync bad fix:口型对不上怎么修,多段课程视频怎么保住同一张脸
长尾词:AI talking avatar lip sync bad fix · text to talking head video for course · AI video face consistency multiple clips
搜 "AI talking avatar lip sync bad fix" 的人,多半已经生成过几版数字人视频,然后发现嘴比声音慢半拍;搜 "text to talking head video for course" 的人,想把一节课变成口播视频;搜 "AI video face consistency multiple clips" 的人,卡在第一条和第二条不像同一个人。
这篇按三段走:先说清问题出在哪,再给通用解法和修复顺序,最后讲 PolyCreator 怎么把这条链路拼成节点。
一、痛点:口型慢半拍、嘴和音素对不上、第二条就换了张脸
抱怨通常是这四条:
- 口型慢半拍。声音已经念到下一句,嘴还停在上一句的形状上。
- 口型和音素对不上。"s" 该是牙齿音,模型给的是圆唇;爆破音落在剪辑点上,嘴来不及闭合。
- 多片段之间换了张脸。第一条是长脸,第二条宽一点、下巴尖一点,剪在一起非常明显。
- 成本被录制吃掉。40 分钟的课程,录一遍加补录用了 3 小时。
根因只有一句话:口型是音频的结果,不是画面的结果。 嘴动得对不对,先取决于音频干不干净、句子切得对不对;脸像不像,先取决于参考图和模型有没有被换过。
二、通用解法:四条路,各管一段
| 方案 | 输入 | 控制力 | 适合 |
|---|---|---|---|
| 数字人生成(HeyGen / Synthesia 一类) | 脚本 + 音色 | 中:口型由平台模型定死,镜头动作受限 | 内部培训、快速铺量、模板固定 |
| 音频驱动对口型(Wav2Lip / SadTalker 一类) | 已有视频或单帧 + 音频 | 中高:换配音不换人,但吃素材质量 | 手里已有真人素材、要救已有成片 |
| 先剪音频,再生成画面 | 音频 | 高:长度、停顿、切点完全由你定 | 课程视频、需要卡点的地方 |
| 统一参考:一张参考图 + 固定 seed + 固定模型 | 一张参考图 | 高:跨片段一致性的核心手段 | 多片段、多集数、同一个人物 |
真实工作流通常不是四选一,而是组合:用数字人或图生视频出画面,用音频驱动对口型修嘴,用先剪音频控制节奏,用统一参考保住同一张脸。
三、对口型修复技巧:按这个顺序改
顺序不能乱,每一步都建立在上一步之上。
- 先修音频。 嘴是音频驱动的,音频不干净,后面全白搭。脚本先过一遍 TTS,语速干净、字与字之间有呼吸;人声底下别垫背景音乐,人声和 BGM 混在一起,模型经常听错起音,口型整体慢半拍;按句子边界切,句间留 200–300ms 停顿。
- 再照顾音素。 口型形状来自音素,所以避免长词连读(一口气三个以上音节的长词),也避免硬辅音(s、b、p、m 这类)正好压在剪辑点上,把爆破音让到句子中间。
- 然后对齐长度。 帧数必须匹配音频时长。片段时长按这条配音的实际长度来定,而不是先定 5 秒、再让声音去凑。多出来的那半秒静音,通常就是"慢半拍"的来源。
- 最后稳住脸。 一句话中间不要大幅转头、不要抬头看别处。头部一动,脸型和五官比例都会漂,嘴再准也救不回来。
一个前后对照:
| 写法 | 文本 | 问题 |
|---|---|---|
| 改前 | "我们在第十一章会详细讲解 Prompt 工程的三个核心原则,以及它们在实际业务中的落地方式。" | 一口气 15 秒,长词连读,"三个核心原则"正好压在剪辑点,结尾必然对不上 |
| 改后 | "第十一章,讲 Prompt 工程。/ 三个核心原则。/ 以及,怎么落到业务里。"(三句,句间各留 250ms 停顿) | 每句 3–6 秒,剪辑点落在元音上,嘴型有闭合时间 |
四、多片段同脸:一张参考图管所有片段
同一张脸跨片段保持一致,靠的是把变量固定住:
- 固定一张参考图,每一条片段都用它当参考输入。参考图换了,脸就换了。参考图如果是生成的,把 seed 记下来,以后重生成用同一个 seed。
- 固定同一个模型、同一条路由。第 3 条片段试了个新模型,第 4 条又换回去,课程里就有两个"人"。
- 同一场次里生成。同样的灯光、背景、衣服、机位高度,尽量放在同一天做完。
- 最后再拼接。所有片段对完一致性,再合成一条片。
五、PolyCreator 怎么做:脚本 → 配音 → 视频 → 发布
PolyCreator 是桌面端的 AI 视频画布,节点就是流程:文本、图片、视频、音频、脚本、发布都是画布上的节点,连线就是数据流。
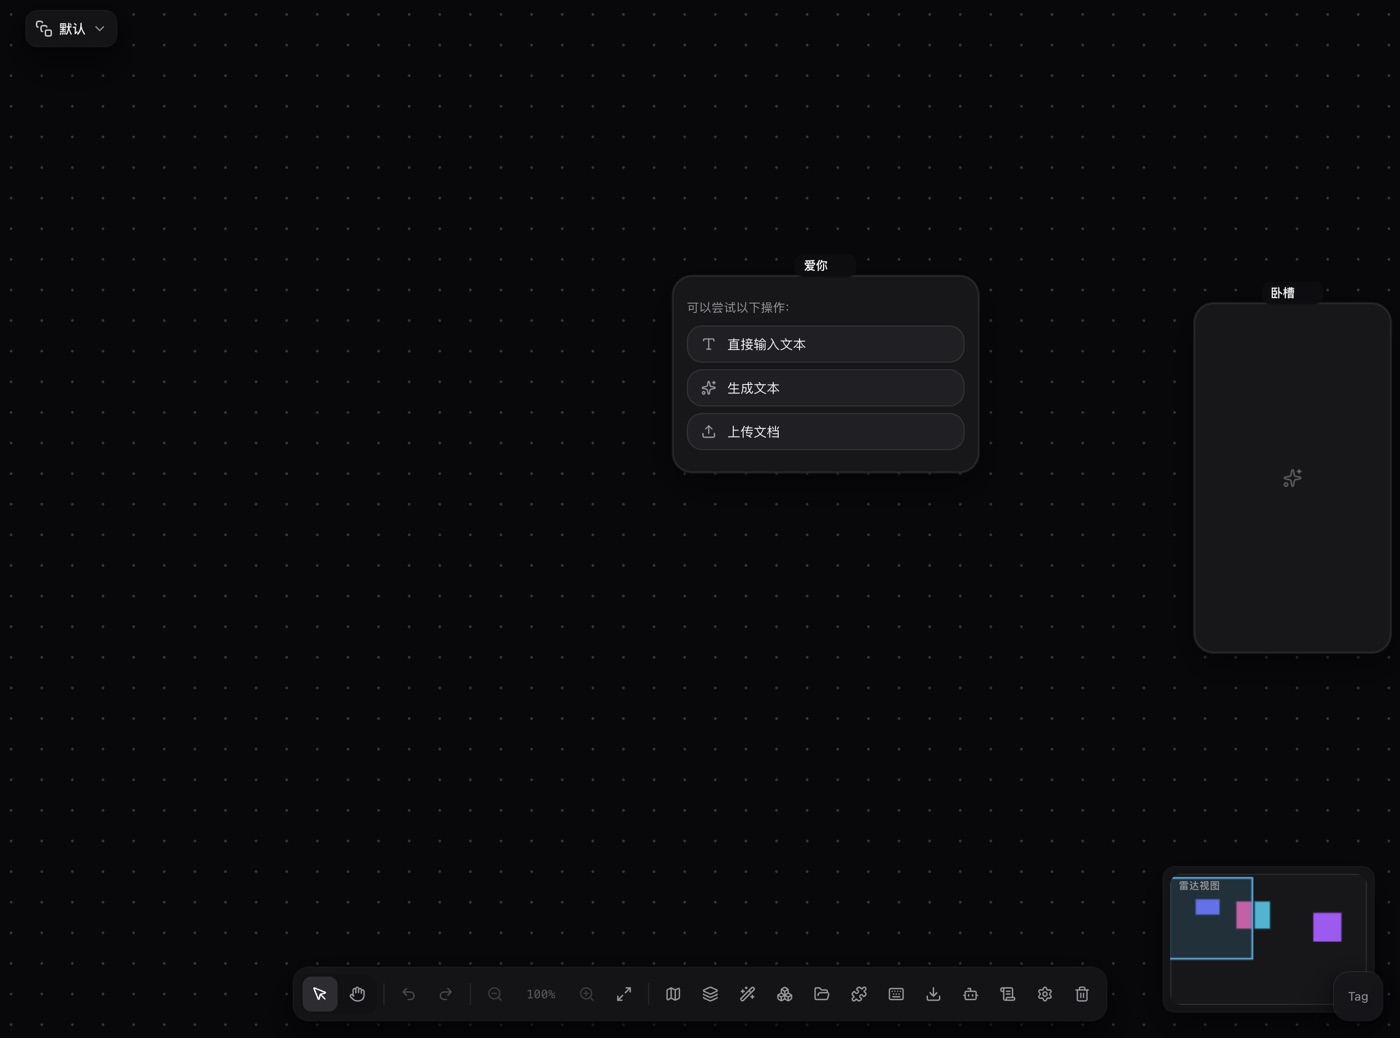
课程口播这条链路,画布上就是几个节点串起来:
- script 节点:放逐字稿,一句话一个片段,先把句子切好。
- audio 节点:配音。音色和时长在节点上选,所有片段用同一个音色、同一个时长;语速也有对应的选项。云端 TTS 或者按自己的 key 接本地模型,都在这一层。
- video 节点:接参考图和配音,时长按这条配音的实际长度设。支持多模态参考的模型会把参考音频一起当参考素材传过去。
- publish 节点:把成片发到平台。
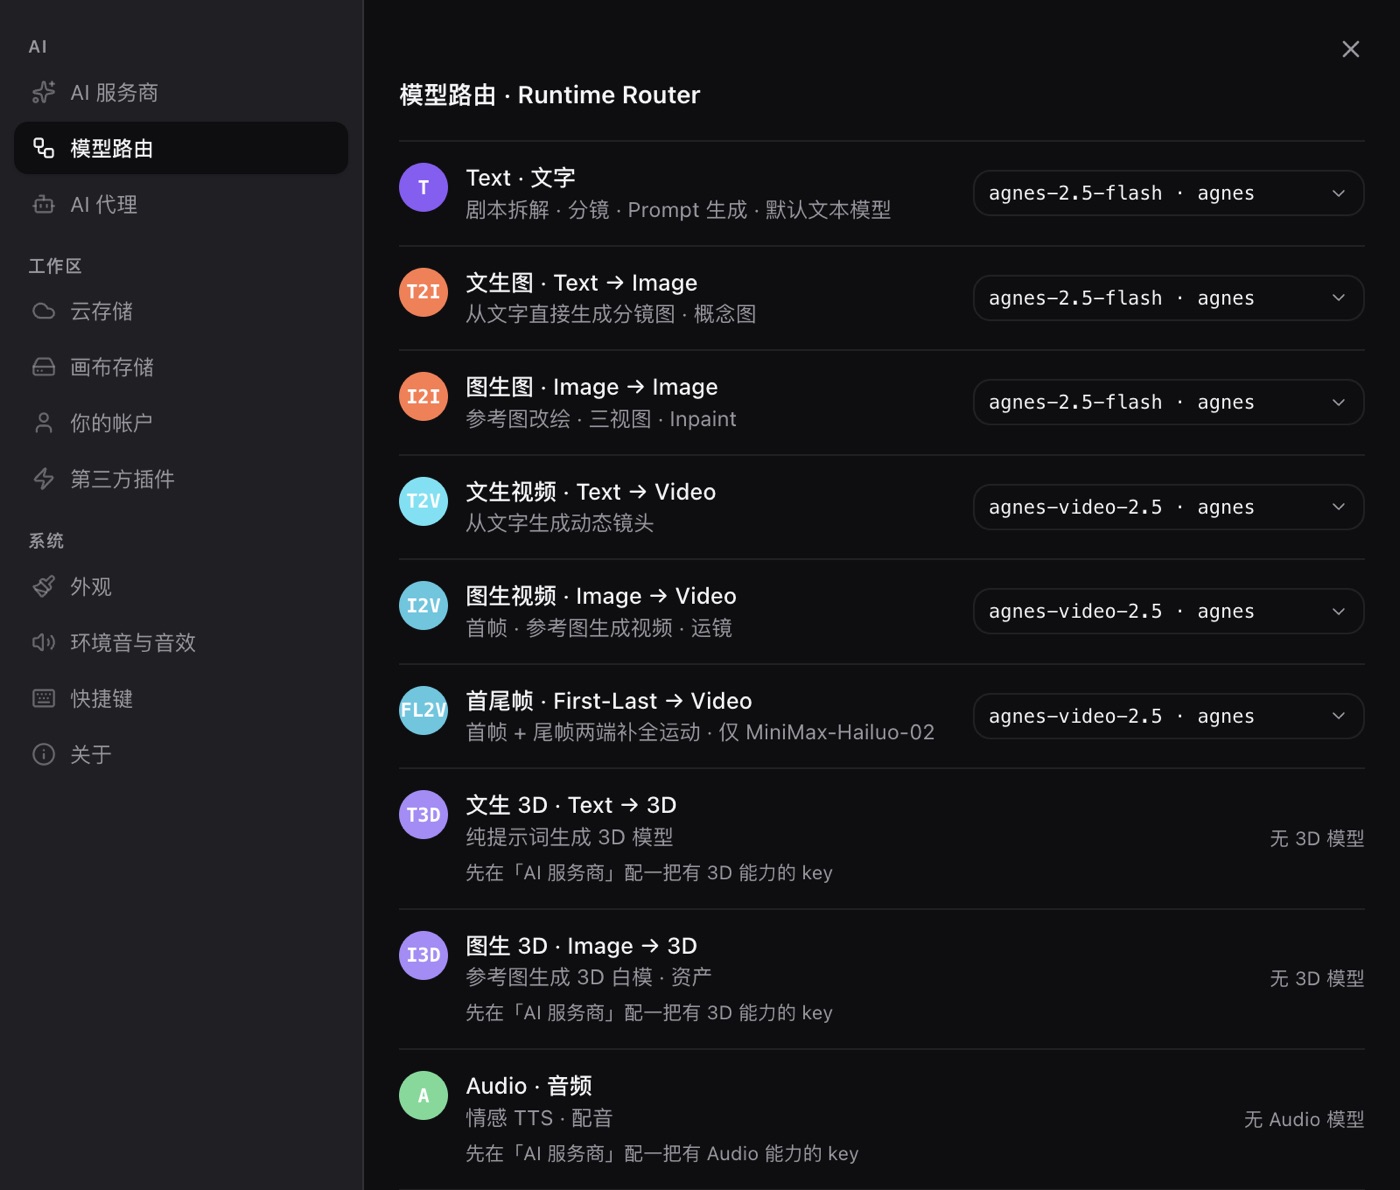
「设置 → 模型路由」决定每个任务走哪个服务商、哪个模型。PolyCreator 不自带对口型模型:对口型的效果来自你路由到的服务商模型。路由面板里那行「对口型 · Lipsync」是给音频类任务留的入口,应用本身没有内置的对口型厂商实现,真跑到这一步会直接报"厂商未配置"。文本任务可以指向本机的 Ollama / LM Studio,让拆稿走本地,配音和视频走云端。
参考图只建一个节点,连线扇出给所有视频节点——这就是"一张参考图管所有片段"在画布上的样子:改一次,所有片段跟着改。
插件可以贡献自己的节点类型和设置页:
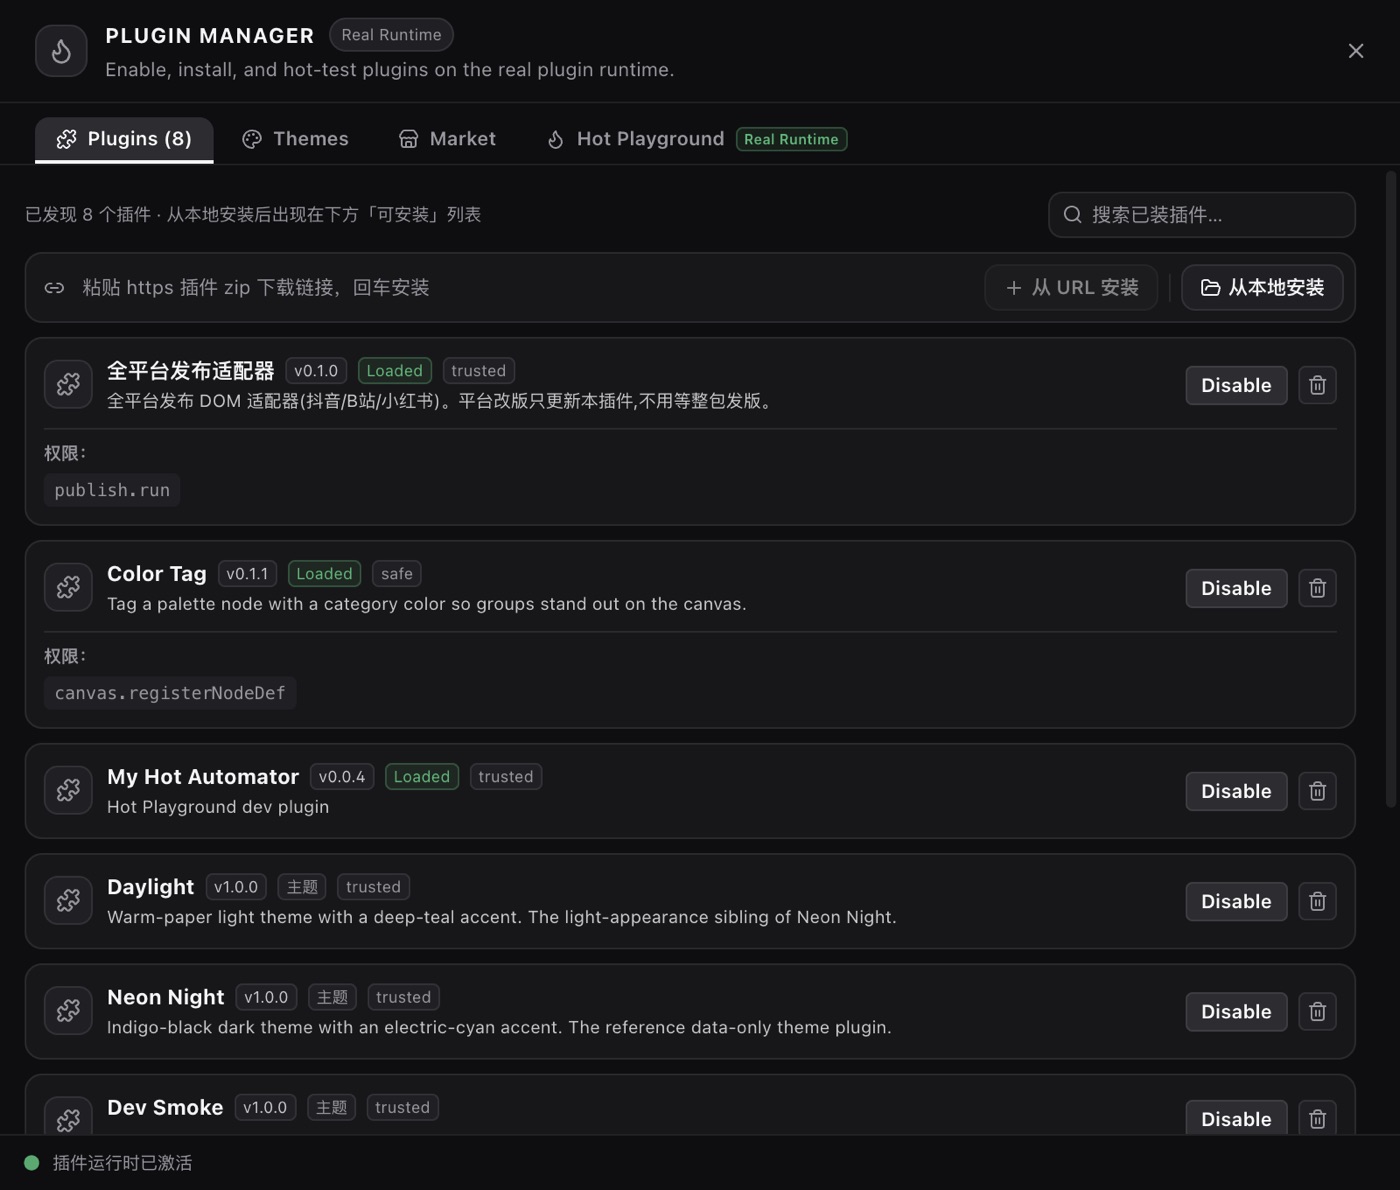
节点级的 SOP:
- script 节点写稿,按句切分。
- audio 节点出配音,确认每条时长。
- 视频节点接参考图节点和配音,时长对齐,模型和路由全程不换。
- 全部生成完,用拼接节点合成一条片(需要本机装有 ffmpeg)。
- publish 节点发出。
常见问题
Q:PolyCreator 有内置的对口型模型吗?
没有。应用是画布与调度层,对口型由你路由到的服务商模型完成。
Q:口型差半拍,先调什么?
先调音频。人声底下别垫 BGM,按句子切,句间留 200–300ms 停顿。音频干净了,再考虑换模型。
Q:一节课要切成多少段?
按句子切,一句一段,3–8 秒一段最好修。太长的句子难切也难修。
Q:两条片段脸不一样?
检查三件事:参考图是不是同一张、模型和路由是不是同一条、是不是同一场次生成的。
Q:可以用本地模型吗?
拆稿可以走本机 Ollama / LM Studio;配音和视频按你路由的服务商执行。
Q:费用怎么算?
按你服务商的单价计费,PolyCreator 不抽成。key 存在本机钥匙串,只在发请求时取出。
相关阅读
- 新手入门:十分钟装好桌面端,认识画布
- 模型与服务商配置:BYOK、模型路由、额度与计费
- 安装与管理插件:给画布加新节点与新能力
- ComfyUI 太难?零门槛节点式生图指南:节点式工作流的心智模型