Stable Diffusion 显存不足怎么跑?本地优化参数与云端方案对比(Stable Diffusion low VRAM how to run)
Stable Diffusion 显存不足怎么跑?本地优化参数与云端方案对比
长尾词:Stable Diffusion low VRAM how to run · run Stable Diffusion on Mac M1 M2 slow fix · local vs cloud AI image generation which better
搜 "Stable Diffusion low VRAM how to run" 的人,多半已经撞上同一堵墙:报 CUDA out of memory,或者在 M1 / M2 上等一张图等了三分钟,风扇转得像要起飞。另一批人搜 "local vs cloud AI image generation which better",想弄明白本地烧显卡、云端按次付费,哪条路更划算。
这篇分三段:痛点背后的真实数字、本地优化的具体参数,然后是本地与云端的对比表、PolyCreator 的云端解法和一份决策清单。
一、痛点:显存报错、Mac 变慢、风扇轰鸣
先对着真实数字看:
- 8GB 显存跑 SDXL 会爆。SDXL 的 UNet 比 SD1.5 大不少,8GB 卡按原生分辨率跑就会
CUDA out of memory。 - 16GB 才算舒服。社区里的经验线是 16GB:跑 SDXL 不折腾,8GB 属于"能跑,但得配合参数"。
- Apple Silicon 是统一内存。M1 / M2 的 16GB 由 CPU 和 GPU 共享,系统先占掉一部分,留给模型的比标称少。8GB 的 M 系列机器跑扩散基本不现实。
- MPS 后端有天花板。macOS 上 PyTorch 走 MPS 通道,部分算子不支持或退回 CPU,明显慢于 CUDA;xformers 这类优化在 Mac 上用不上。
- 笔记本还要兼顾温度。持续出图让 CPU / GPU 满载,风扇噪音、耗电、机身温度一起上来。
所以"能跑"和"跑得舒服"是两件事:前者靠调参数勉强达成,后者要么换硬件,要么把生成环节整个挪走。
二、本地优化:具体调什么,代价是什么
下面是社区里最常用的一组手段。效果几乎都是"省显存",代价落在速度或画质上,没有哪一条是白拿的。
| 措施 | 效果 | 代价 |
|---|---|---|
| 换注意力实现(xformers / SDP / memory-efficient attention) | 降低注意力的显存峰值 | 对 CUDA 与 PyTorch 版本敏感,装不上很常见;Mac 上用不了 |
| attention slicing(分块注意力) | 显存占用明显下降 | 出图变慢 |
| VAE tiling(分块解码) | 高分辨率解码不再爆显存 | 略降速,偶尔见拼接痕迹 |
--medvram / --lowvram 启动参数 |
自动按需切分,省显存 | 全程更慢,部分管线退化 |
| FP16 半精度 | 显存占用大约减半 | 少数算子数值不稳,个别模型发灰 |
| 换更小的模型(SD1.5 代替 SDXL) | 显存和耗时一起降 | 画质上限低一档,文字能力弱 |
| 降分辨率(512 代替 1024) | 显存与耗时随像素数下降 | 细节变少,不能直接出高清图 |
| batch size 设为 1 | 省显存 | 批量出图得一张一张等 |
| 量化权重(NF4 / FP8 一类) | 更小显存上跑更大的模型 | 依赖量化实现,质量有波动 |
| Apple:MPS 后端 + ComfyUI 的 MPS 支持 | 让 Mac 至少能跑起来 | 远慢于 CUDA,部分算子退回 CPU |
Apple:--preview-method none |
关掉实时预览,少一份开销 | 看不到生成过程 |
叠起来 8GB 机器确实能"跑起来",代价是慢、画质打折、配置本身也要搭进去不少时间。真正的分水岭是:你优化的是一张卡的显存,还是把整个生成环节挪走?
如果手边就是一台 Mac
顺序有讲究:先走 MPS 后端并确认工具支持,再关掉实时预览(--preview-method none),从 512 分辨率起步,稳了再往上加。配好之后 MPS 仍远落后于 CUDA 卡——到了这一步,该比的不是"改哪个参数",而是"我的时间值多少"。
三、本地 vs 云端:怎么算这笔账
| 维度 | 本地跑扩散模型 | 云端 API |
|---|---|---|
| 前置成本 | 一次性硬件投入:显卡,或一台内存够的 Mac | 没有硬件投入,按次计费 |
| 长期成本 | 电费与设备折旧 | 每次调用付费,用多少付多少 |
| 隐私 | 数据不出机器 | 请求会发给你选的服务商 |
| 速度 | 受本地硬件限制,慢就是慢 | 取决于服务商的排队与算力 |
| 质量上限 | 受限于你能跑得动的模型大小 | 可以直接调用当前最强的一档模型 |
| 维护 | 自己管驱动、依赖、模型版本、磁盘 | 服务商负责环境与模型更新 |
| 灵活性 | 能训自己的 LoRA、接自定义采样管线 | 只能用服务商开放的接口与参数 |
| 适合人群 | 要训模型、要离线、产量可控的人 | 设备不够、产量大、要最新模型的人 |
一句话概括:本地是一次性硬件换长期电费,云端是按次付费换零维护。钱花在不同地方,所以没有绝对优劣,只有跟你用得多的那件事是否匹配。具体单价各家官网为准,本文不列价目表。
本地成本是一次买入、之后基本忘掉;云端成本随用量走,闲时为零。交叉点取决于你的量,也取决于你愿不愿意把"本地出一张图二十分钟"算进成本——这笔时间账从不出现在任何账单上。
四、PolyCreator 怎么做:不本地跑模型,只做画布与路由
先把话说清楚:PolyCreator 不在本地跑 Stable Diffusion,也没有内置扩散模型。它的定位是桌面端的画布与工作流层,真正出图的是你配置的服务商 API,模型跑在服务商的服务器上。
这带来三个直接结果:你的机器不需要为模型准备显存;模型是按名字选的而不是按文件选的,换新一档改配置即可;本地与云端可以混用,文本这类轻任务走本机的 Ollama / LM Studio,图像和视频交给云端。
第一步,在「设置 → AI 服务商」里填自己的 key。
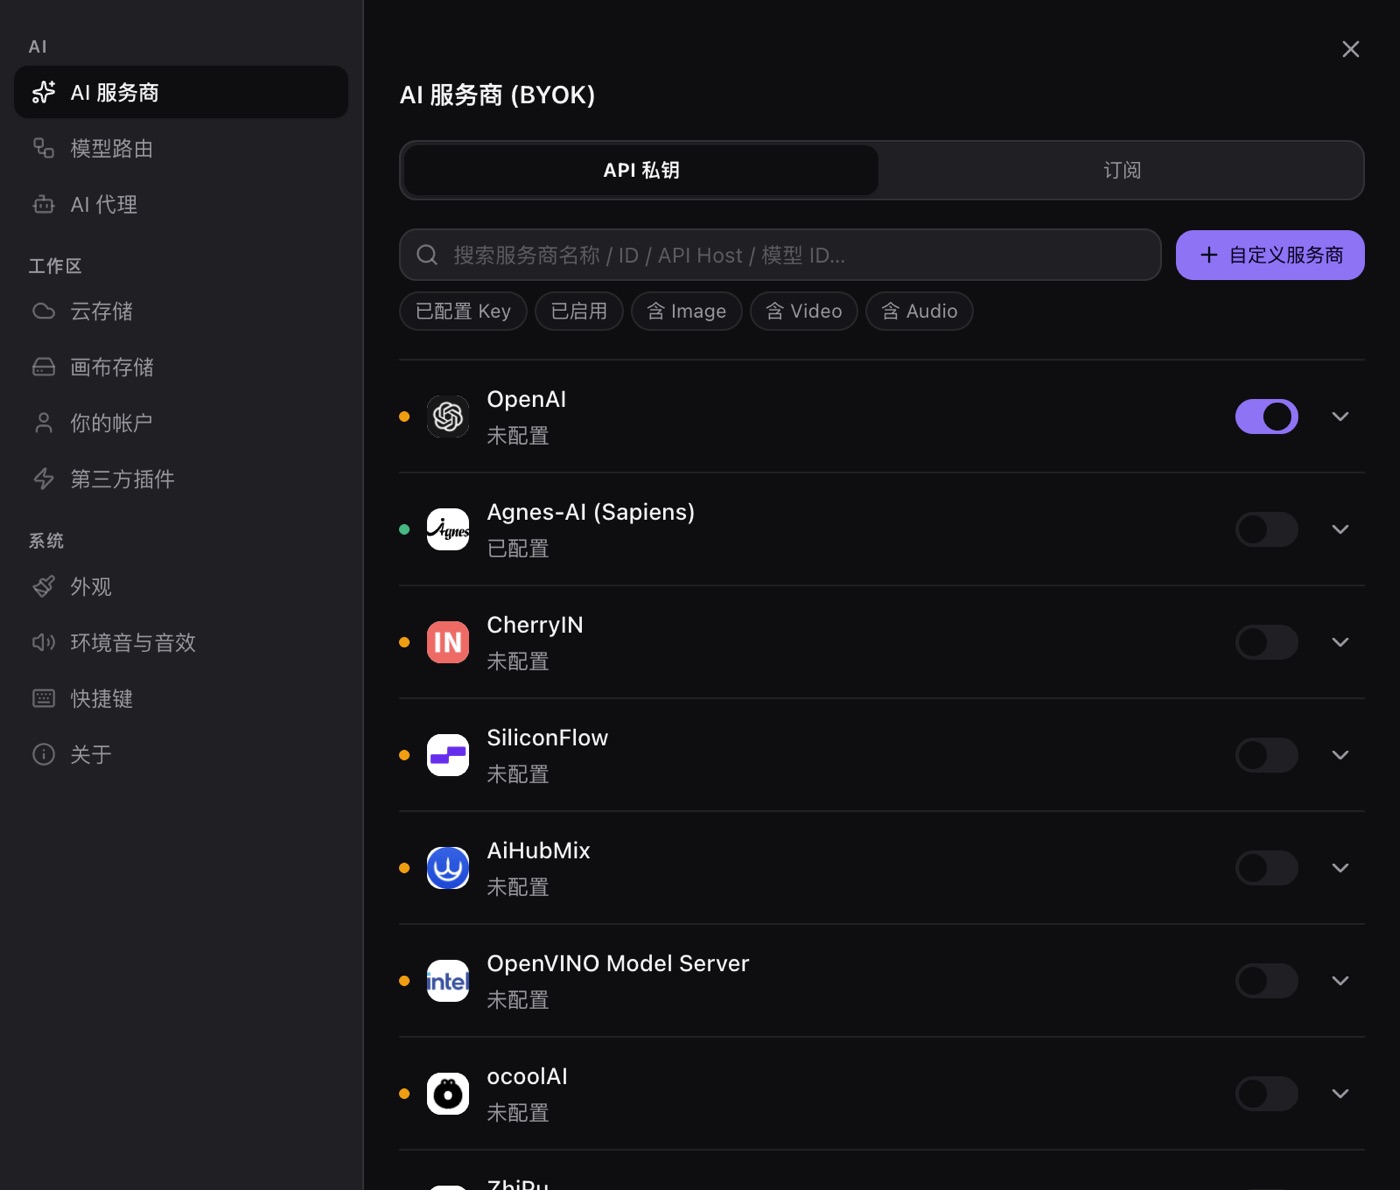
Key 保存在本机系统钥匙串(safeStorage 加密),只在发请求时取出,不上传到别处。App 不代转你的 key,也不额外收推理费。
第二步,在「设置 → 模型路由」里给每类任务指定服务商和模型。
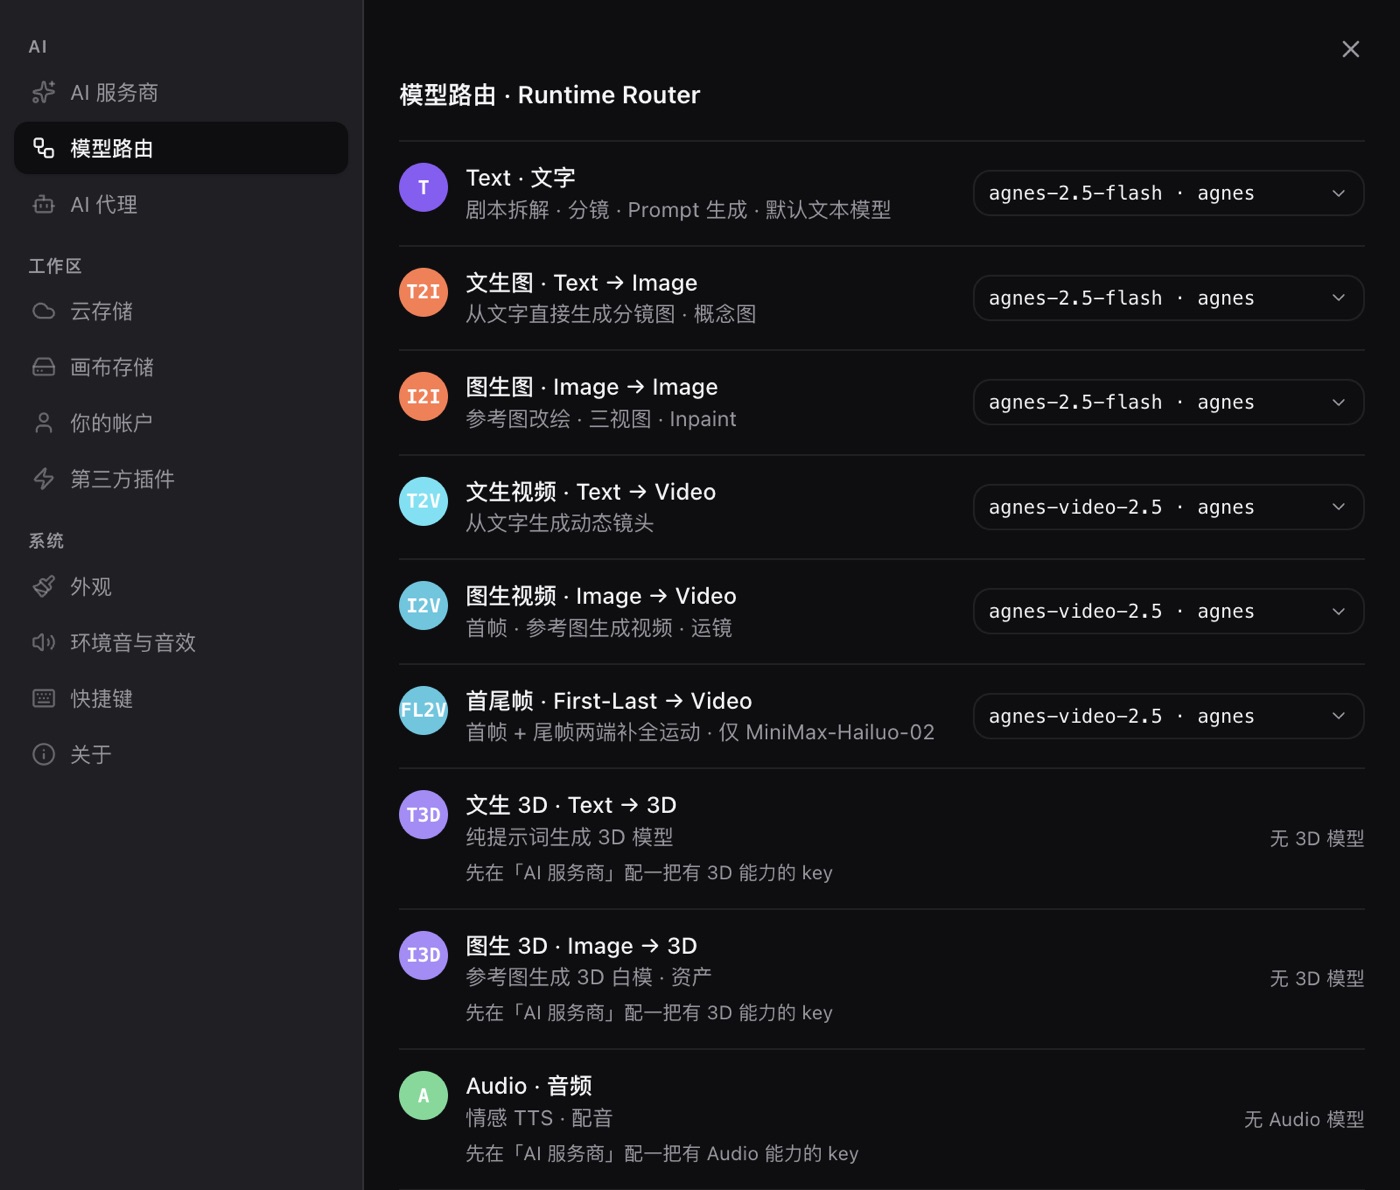
路由的意义正在于按任务分流:文本任务可以指向本机的 Ollama / LM Studio(模型在你机器上跑,不出网),文生图和视频任务指向云端。节点上也能单独指定模型,临时试别的配置不影响全局。
最常见的混用配置是:剧本拆解、分镜、提示词改写交给本机模型,图像和视频交给云端。
第三步,在画布上把节点连起来就跑。
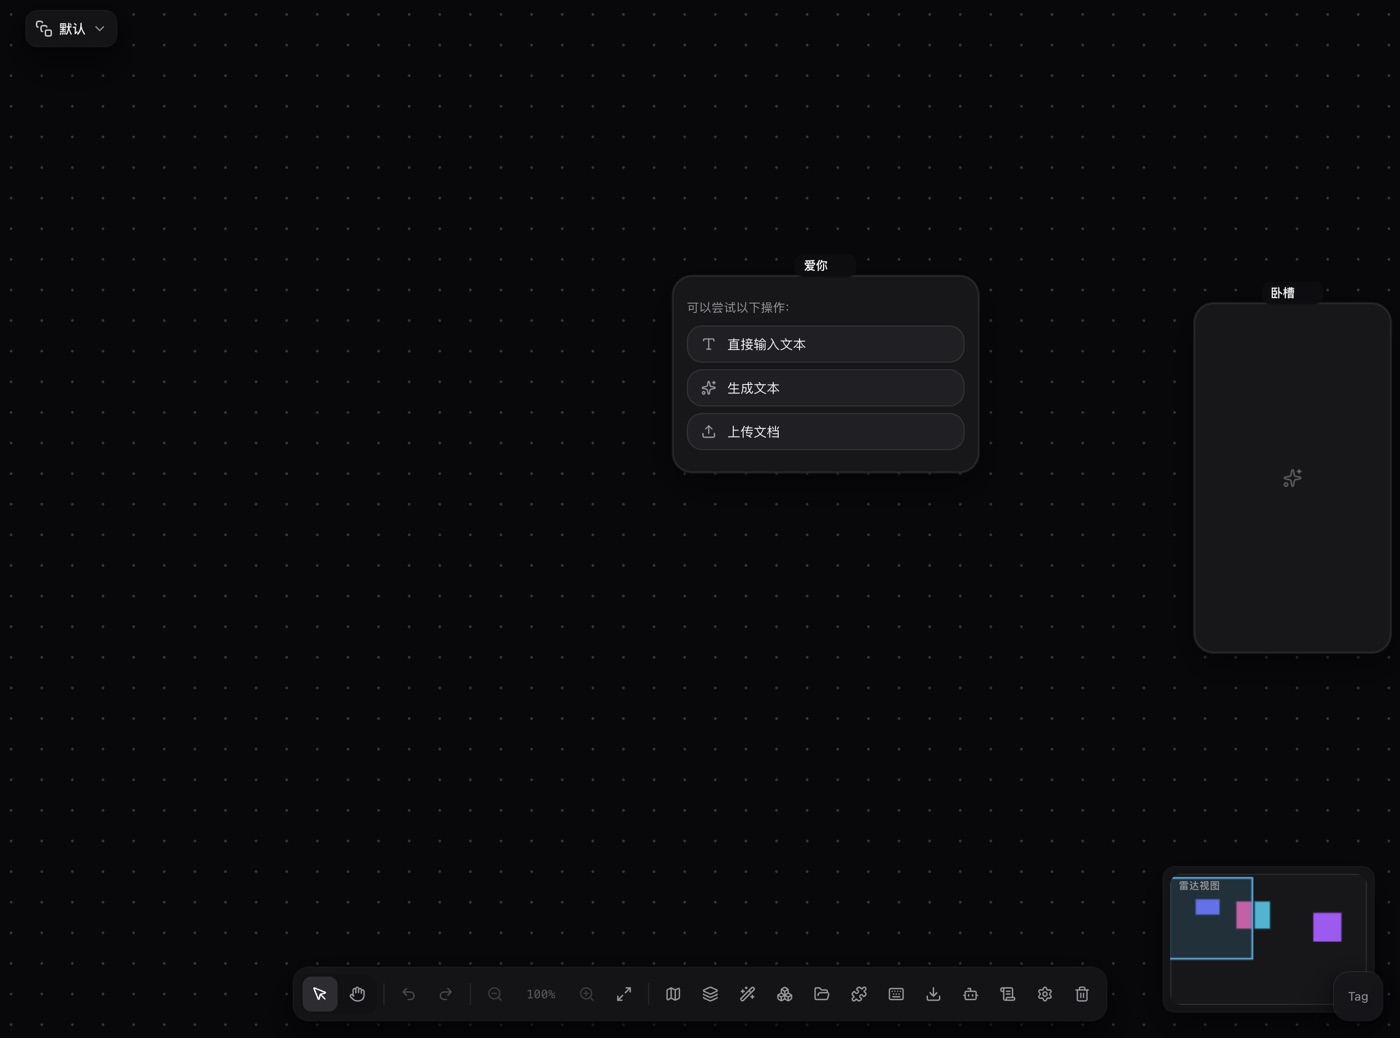
图里是真实的节点画布:输入、文本、视频生成节点用连线串成流程,结果落在节点里。
需要说清的边界:应用对本地模型的支持覆盖的是文本模型(Ollama、LM Studio 这类本机推理服务),不包含本地扩散模型。想在本地跑 Stable Diffusion,仍要回到 ComfyUI / AUTOMATIC1111 这条路线。
五、决策清单:四个问题定路线
按顺序问自己:
- 你的显存或统一内存有多少? 8GB 以下或只有核显 → 直接上云端,本地调参的收益抵不上折腾成本。
- 数据能不能出网? 不能出网(涉密、离线环境)→ 必须本地,接受速度和画质上限。
- 你要的是能跑,还是跑得好? 偶尔试一张图本地够用;要批量、要高清、要最新模型的能力,云端更划算。
- 要不要训自己的模型(LoRA、微调)? 要 → 本地,这本来就是本地路线的强项。
四问里只要有一问答"必须本地",就走本地;否则云端通常更省心。
常见问题
Q:PolyCreator 能本地跑 Stable Diffusion 吗?
不能。应用不内置扩散模型,也不做本地推理,出图调用你配置的服务商 API。
Q:那我在 Mac 上能做什么?
做画布编排、节点连线、资产管理这类不费显存的活,也能把文本任务交给本机的 Ollama / LM Studio。
Q:云端是不是每次都更贵?
不一定。量小的时候按次付费很便宜;量大、模型又要频繁更新时,本地摊薄一次性硬件投入可能更划算。
Q:走云端画质会掉吗?
不会。画质取决于你选的那个模型,与它在哪台机器上推理无关。